转写准确率怎么提高:已录完的音频怎么补救,下次录音改什么
很多人搜「转写准确率」,是因为手里已经有一段音频,转出来的稿子错得没法看:人名全是同音字,金额多了两个零,两个人抢话的地方整段糊成一团。这时候再去看「下次要靠近麦克风」的建议,没有意义——那段采访已经结束了,不可能重录。
所以这篇分两条路:还能重录的,只改三件事;不能重录的,走补救流程。再给三样工具:从错误类型倒推根因的对照表、热词表的维护方法、把校对时间花在刀刃上的分区法。
先分岔:还能重录吗
这一步不分清,后面的建议都是空话。
| 处境 | 典型素材 | 该做什么 |
|---|---|---|
| 能重录 | 自己的口播、课程试讲、可约二次的访谈 | 只改三件事:距离、环境、轮流说话。改完立刻用同一段文字复测 |
| 不能重录 | 已结束的会议、客户通话、庭审、现场采访、他人提供的录音 | 走补救流程:剪静音 → 适度降噪 → 切片 → 语言与热词 → 分区校对 |
能重录的情况下,优先顺序很明确:把麦克风挪近 > 换个安静的屋子 > 让大家轮流说。这三件事都不花钱,效果比换工具大。设备档次排最后——放在桌角的好麦克风,不如放在说话人手边的手机。
「靠近」的标准:单人说话,手机放在一臂之内;两人对谈,放在两人中间偏声音小的那位;会议桌,放桌子中央而不是自己座位旁。离得最远的那个人,决定整份稿子最烂的那一段。
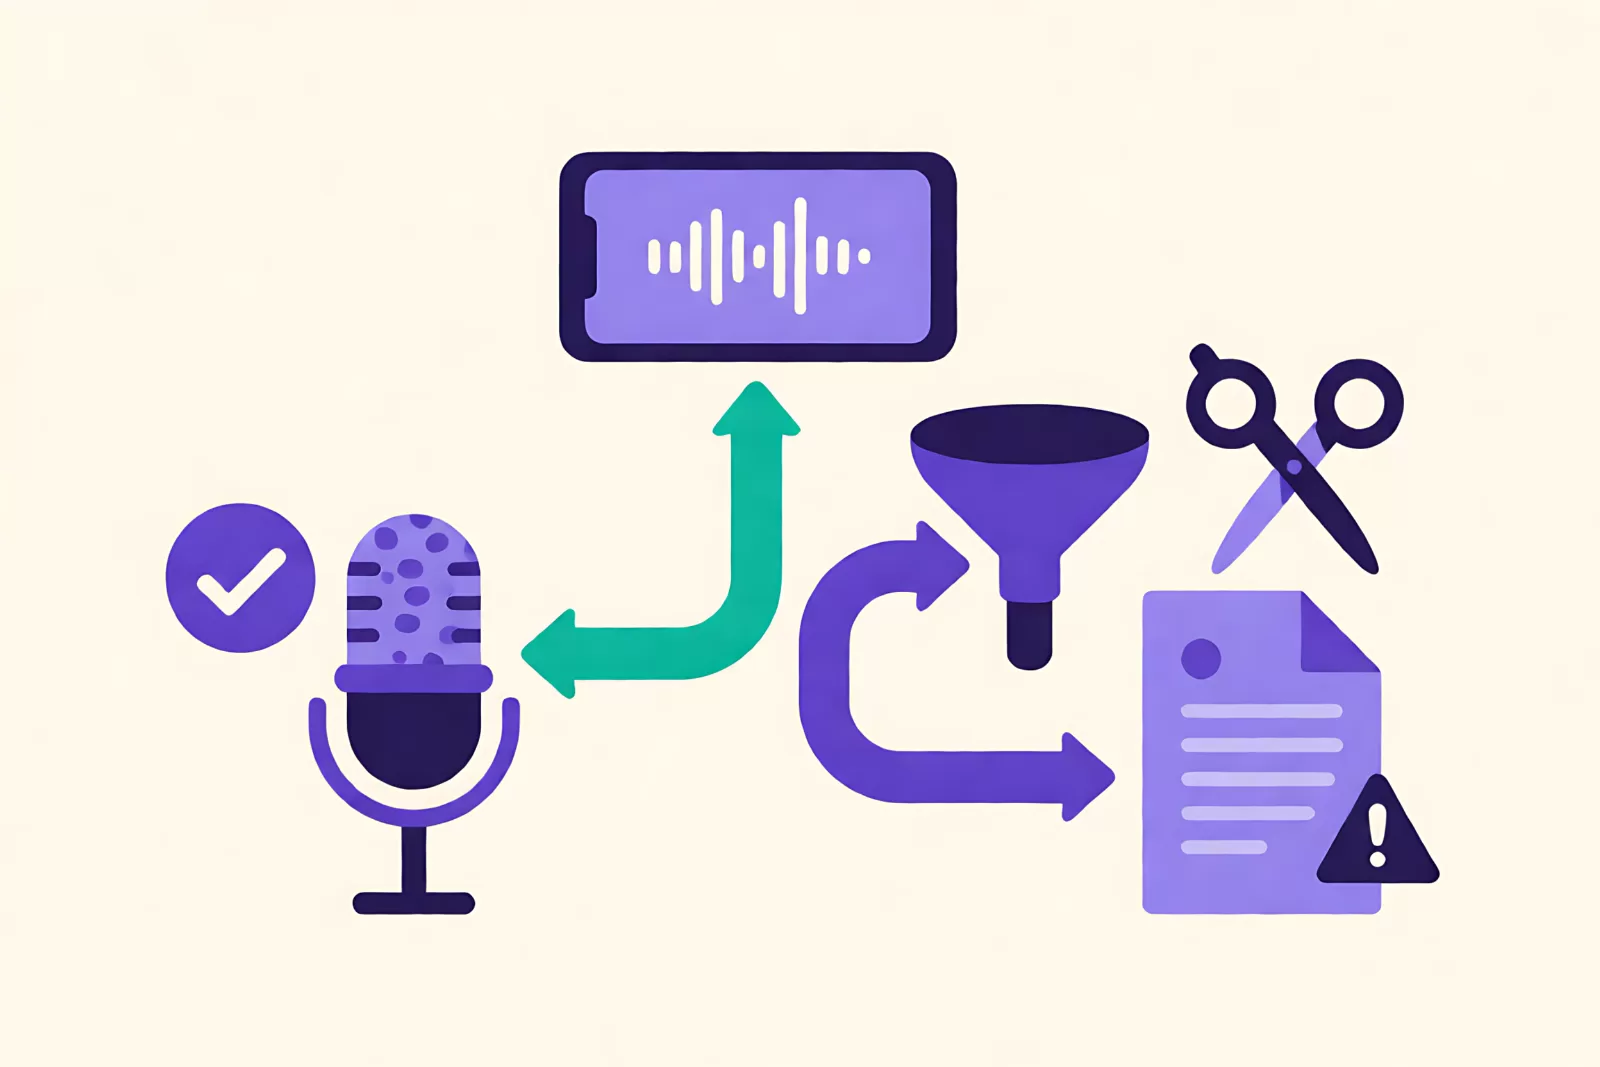
不能重录时的补救四步
第一步:剪掉长静音和无关段
这是最容易被跳过、收益却很直接的一步。长段静音不只浪费时间,还会诱发「凭空补句子」——转写模型在安静段落里有时会自己编出一句,而这句话录音里根本不存在,校对时极难发现(因为它读起来很通顺)。
做法:会议前的寒暄、中途休息、结束后的闲聊剪掉,超过十几秒的静音压到一两秒。剪完再转,稿子会短一截,编造句也少很多。
第二步:降噪要克制,宁可留一点底噪
降噪不是越干净越好。人声的辨识依赖辅音(s、sh、t、f)和高频细节,而多数降噪算法优先削掉的正是这些。降得太狠,人耳听着「干净了」,模型反而听不清,错词变多。
判断办法:同一段音频,降噪前后各转一次,比较错词数量。降噪后错得更多就说明过头了,把强度调回去;只压掉了空调嗡嗡声、错词略减,就是合适档位。这比任何参数推荐都可靠,因为素材差异太大。
第三步:切片,10~20 分钟一段
长音频有两个问题:一是超过工具的单文件限制会直接失败;二是一旦中途出错,整段要重来。切成 10~20 分钟一段,逐段转写,最后按顺序拼接。
- 切片点选在自然的停顿处,不要切在一句话中间;
- 文件名按「日期_主题_序号」命名,拼接时不会乱;
- 每段转完先看最后一句是否对得上录音结尾,这是最快的完整性检查。
第四步:语言设置与热词表
语言设置不要用「自动检测」。中文素材选了自动检测,遇到中英混说就会来回跳,同一句话可能一半中文一半英文;明确指定主语言,混说的部分再人工补。
热词表(有的工具叫自定义词典、术语库)是补救流程里性价比最高的一环,具体做法见下面「热词表」一节。
从错误类型倒推根因
比起记「因素排序」,看稿子时更实用的是:这段错成什么样,就去查对应的原因。下面这张表按「错法」组织,可以对着稿子直接查。
| 错成什么样 | 大概率根因 | 该做什么 |
|---|---|---|
| 人名、公司名每次错成同一个词 | 模型没见过这个词,只能按发音猜 | 加进热词表;同一段重转一次,通常立刻改善 |
| 数字、金额、日期错,但语义通顺 | 数字在语音里信息量低,靠上下文补不出来 | 不改设置,直接列入「必须回听」;说话时刻意放慢 |
| 整段变糊、句子断裂 | 多人抢话,或说话人离麦太远 | 剪辑时把这段单独标记;只能人工听写,别指望重转 |
| 安静段落冒出没说过的话 | 静音诱发补句 | 剪掉长静音再转;这类句子必须删 |
| 中英混说处来回跳语言 | 语言设置用了自动检测 | 指定主语言;混说段落人工补 |
| 语气词、重复大量出现 | 不是错误,是逐字稿的正常形态 | 不用管,整理阶段统一清理 |
热词表:20~50 个,只放专有名词
热词表的作用是告诉模型「这些词会出现在这段音频里」,从而减少按发音瞎猜。它有效,但有两个反直觉的限制:
- 不是越多越好。热词太多会稀释权重,模型开始把普通词往热词上靠,反而制造新错误。经验区间是 20~50 个,按素材复杂度调整,不同工具差异很大;
- 只放专有名词。人名、公司名、产品名、地名、行业术语、缩写。不要放「因为」「所以」这类常用词,它们本来就不会错,放进去只是占位置。
维护方法:建一个长期使用的表(比如一个纯文本文件),每次转写完把「这次新出现的错词」补进去,标上正确写法。三个月后这张表会覆盖你 80% 的素材,新项目的校对时间会明显下降。做采访、做研究的尤其值得——同一批受访者、同一批机构名会反复出现。
两次转写比对法:十分钟验证一个变量
不要靠「听起来更清楚」来判断处理有没有效,那对人耳成立,对模型未必。更可靠的做法是控制变量做一次对比:
- 选一段有代表性的两分钟音频(含人名、数字、至少两个人说话);
- 按当前设置转一遍,记下错词位置;
- 只改一个变量——加降噪、或指定语言、或加热词——再转一遍;
- 对比两版在同样位置的差异。差异集中改善,说明这个变量有效;没有变化或变差,就别加。
这个方法的价值在于:它能告诉你哪一项对你的素材真的有用。别人说降噪有效,你的素材可能越降越差;别人说换大模型有用,你的问题可能只是人名没进热词表。
校对成本分区:把时间花在刀刃上
提高准确率的最终目的不是「数字好看」,而是减少返工。所以最后一环是把稿子分区,不同区投入不同精力。
| 分区 | 包含什么 | 投入 |
|---|---|---|
| 必须回听 | 人名与职务、金额与日期、否定句与条件句、承诺与结论、直接引语 | 逐条对照录音,一个字都不放过 |
| 抽查 | 背景描述、过程叙述、举例 | 按段落抽 20%~30%,读不通的地方回听 |
| 可以跳过 | 寒暄、语气词、重复、与主题无关的闲聊 | 直接删,不必核对 |
这张表的效果,是把「从头听到尾」变成「只听关键段落」。一小时采访的校对时间通常能压掉一半以上,漏错风险反而更低——因为你把注意力放在了真会出事的地方。
「否定句」值得单独强调:丢一个「不」字,意思会整个反转,而句子读起来毫无破绽。凡是带「不」「没」「除了」「除非」的句子,都按必须回听处理。
五个常见误区
- 以为换更贵的工具就能解决。录音条件差的时候,换工具只是换一种错法。先做两次转写比对,确认瓶颈在音源还是模型;
- 迷信更高的采样率。多数识别引擎内部会把音频重采样到较低采样率再处理,96kHz 的录音和普通语音备忘录差别很小。把力气花在距离和环境上;
- 降噪开到最大。削掉辅音,错词变多。判断标准只有一个:处理后重转,错词有没有减少;
- 热词表堆几百个词。权重被稀释,普通词开始被误改成热词。控制在几十个,宁少勿多;
- 只看宣传的准确率数字。那些数字来自特定的测试集,和你的素材无关。唯一有意义的准确率,是你自己那段音频测出来的。
自查清单
- 先判断了「能不能重录」,没有把预防建议套在已录完的素材上;
- 长静音与无关段已剪掉,编造句已清理;
- 降噪做过前后对比,确认错词减少而不是增加;
- 长音频已切片,文件名能对应顺序;
- 语言指定为素材主语言,没有用自动检测;
- 热词表已更新,数量在几十个量级,只含专有名词;
- 稿子已按三档分区,必须回听的部分逐条核过;
- 否定句、数字、引语单独抽查过一遍。
常见问题
准确率到底能到多少?
不给具体数字,因为它随素材变化太大。安静环境、单人、吐字清楚时,多数工具的结果只需改名词与数字;远场收音、多人抢话、方言或中英混说时,错词密度成倍上升。判断标准应是「哪些段落必须回听」,而非一个百分比。
手机录音和专业录音笔差多少?
差距主要来自距离,不是设备。手机放在说话人一臂之内,往往好过放在房间另一头的录音笔。只有当专业设备(比如领夹麦)能放得更近时,它才真正拉开差距。
口音重怎么办?
口音带来的误差靠设置解决不了,能做的是三件事:选支持该口音/方言的引擎;把反复出现的人名与术语放进热词表;在必须准确的段落接受「人工听写」。强行要求机器全对,只会浪费时间。
加了热词反而更差,是什么原因?
大概率是热词太多或太泛。砍到几十个、只留专有名词,再用两次转写比对法验证。另外注意有些工具的热词区分大小写与全半角,写法不一致会失效。
录音里有背景音乐,还能救吗?
能转,但预期要降低。音乐既是噪声,又可能被模型当成歌词去转写。可行做法是先剪掉纯音乐段,人声与音乐重叠的部分只能人工核对。下次录之前把音乐关掉。
小结
提高转写准确率的关键,是先分清处境:能重录的改三件事(距离、环境、轮流说),不能重录的走补救(剪静音、克制降噪、切片、语言与热词)。判断有没有效不要靠感觉,用两次转写比对法,一次只改一个变量。最后按三档分区校对,把时间压在名词、数字、否定句和引语上。
素材还在手机里、还没导出来的,先看 语音转文字的导出与校对流程;转完要整理成稿,见 采访录音整理成稿;会议场景的方法在 会议录音怎么整理成纪要。